我们如何测试 SKU.md 是否真的帮助 AI 找到更合适的商品
v1.0.0 专题
一套预注册的 A/B Benchmark 设计,在相同检索预算、盲评和可复现实验材料下比较普通商品页与 SKU.md。
当前状态: 本文依据当前 v1.0.0-beta 边界撰写,只陈述方法和证据要求,不把尚未验证的平台采用、排名、引用、推荐或销售结果写成事实。
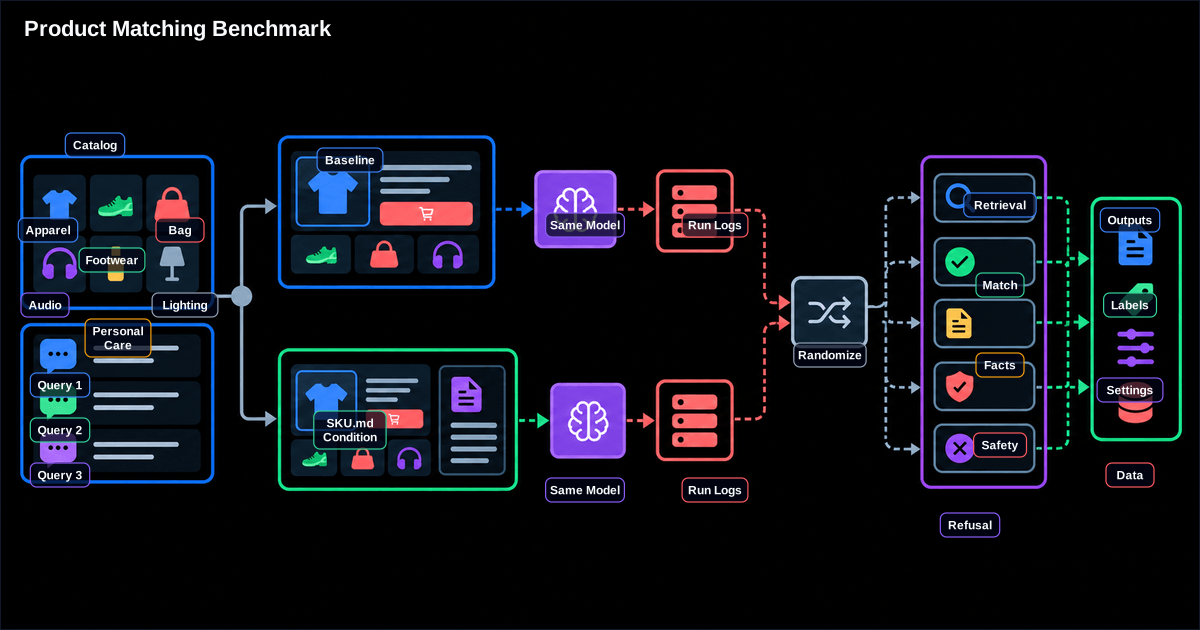
Benchmark 应回答一个范围明确的因果问题:在其他条件一致时,访问 SKU.md 是否改善了定义好的商品匹配任务?它不能为了制造好看的发布数字而设计。本文现在公开实验协议;完整实验可复现前,不发布结果结论。
预注册研究假设
在看到结果前写明商品样本、购物问题、预期约束、评分规则、模型、检索预算、提示词和排除规则。主比较只包含两组:普通公开商品资源,以及同样资源加 SKU.md,其他条件全部保持一致。
同时定义什么结果代表没有改善或产生伤害。无法否证自身主张的 Benchmark 只是营销材料。
建立有代表性的问题集
覆盖精确查找、属性比较、兼容性、使用建议、限制敏感请求、身份和变体问题,以及应交给实时系统的问题。既采样资料完整的商品,也采样信息稀疏商品,并保留隐藏评估项,避免作者针对每道题优化文档。
标注者要记录硬约束、可接受替代、决定性来源,以及是否预期拒答。
评分不能只看检索
同时衡量正确候选是否被取回、决定性事实是否准确、来源是否支持陈述、限制是否得到尊重,以及证据不足时是否正确拒答或追问。单一首选准确率可能掩盖不安全解释。
样本较小时报告置信区间或逐题结果,不能把实验差值扩大成排名、引用、转化或所有模型的承诺。
对评审隐藏实验条件
人工评分前移除分组标签和展示线索。主观适用性至少由两名评审判断,预先定义分歧解决方式并保留备注。精确标识符和来源 URL 可以自动评分,复杂推荐仍需明确 rubric。
保存可复现实验包
| 材料 | 必须包含 |
|---|---|
| 语料 | 精确页面与 SKU.md 版本或快照 |
| 问题 | 提示词、约束、预期动作 |
| 运行环境 | 模型、消费者、依赖和配置 |
| 随机性 | 种子与采样设置 |
| 输出 | 原始答案、检索资源、引用 |
| 评分 | rubric、评审决定、脚本 |
| 失败 | 排除项、超时、格式错误案例 |
失败案例必须和平均值一起发布
展示 SKU.md 没有产生差异、引入陈旧或冲突知识、造成错误匹配的案例。这些材料决定下一步要改规范还是改写作方式。没有失败分析的平均提升很难可信。
结果发布条件
只有第二位人员能够执行文档化流程,并在声明容差内复现结果表,才能发布 Benchmark 结果。满足条件前,文章只描述实验协议,不写虚构结果。
运行前固定比较条件
Baseline 与 SKU.md 组必须使用相同商品、问题、模型、预算、工具和实时状态政策,唯一计划内差异是能否使用 SKU.md。冻结快照,记录版本、提示、随机种子、超时和失败。若一组有更多抓取预算或人工修正候选,实验就无法隔离文件作用。
问题要覆盖事实、兼容、Limitations、Variant、意图歧义、缺失证据和实时交接,并包含近似商品与没有正确推荐的案例。除 Recall 外,还要评分事实、来源、硬约束、错误推荐、拒答和交接;延迟与资源单列。
盲评并公开失败
在人工评审前隐藏组别,主观项目至少两人评分,按预先规则解决分歧。复现实验包包含输入、快照、配置、原始输出、评分代码、裁决和汇总。
平均值旁必须放分类结果和代表性失败。只有独立人员能重跑并在声明容差内得到结果,才能发布 Benchmark 结果。在此之前,本文只是方法,不能预写正面结论。
防止题目污染与选择性报告
不能用最终评估题反复改写 SKU.md。问题应分开发与保留集,记录开发错误引发的内容修改,协议冻结后才打开保留集。看过结果再重跑,必须作为新实验公开,不能覆盖不利结果。
所有预注册指标都要报告,包括中性或负面结果;随机模型应给出多次运行波动。缺失输出、工具失败和预算耗尽按事先规则计入分母。即使结果很好,也只支持这组数据、消费者、模型与版本,不能推成平台采用、排名或转化保证。
把编辑成本也纳入报告
如果 SKU.md 只有在针对测试题反复改写数小时后才更好,这项成本必须和质量结果一起公布。记录准备时间、新增说法数量、校验失败和维护步骤,避免把隐藏调参劳动转移到新文件。
结果解读也要看权衡:来源准确率提高而 Recall 不变可能仍有价值;Recall 提高却增加不兼容推荐可能有害。没有一个总分能代替分类结果与失败案例。
发布前做一次泄漏审计
检查评估答案是否直接出现在提示、文件名、摘要或评分元数据中,确认评审者不能从格式猜出实验组,并验证两组的失败处理完全相同。把审计结果和实验包一起保存。
很小的信息泄漏也可能制造看似明显的优势,却没有改善商品理解。因此泄漏应视为阻止发布的问题,而不是报告脚注。修复后要作为新运行重新执行,不得只删除异常样本。
最后还要核对七语版本是否使用同一实验边界、指标和结果发布条件。任何语言都不能把计划中的假设写成已经出现的正面结果,也不能省略失败案例、成本或拒答质量。
失败样例与成功结果同样重要
公开结果时不能只展示命中案例。每次实验还应列出错误检索、事实引用错误、不当推荐、应拒答却回答,以及依赖实时状态却未交接的样例。评审者需要在不知道实验条件的情况下打分,随后再解盲比较两组表现。模型版本、提示、数据快照、随机顺序和运行日志必须一并保存,才能让第三方复现实验。