我們如何測試 SKU.md 是否真的幫助 AI 找到更合適的商品
v1.0.0 專題
一套預註冊的 A/B Benchmark 設計,在相同檢索預算、盲評和可重現實驗材料下比較普通商品頁與 SKU.md。
目前狀態: 本文依據目前 v1.0.0-beta 邊界撰寫,只陳述方法和證據要求,不把尚未驗證的平台採用、排名、引用、推薦或銷售結果寫成事實。
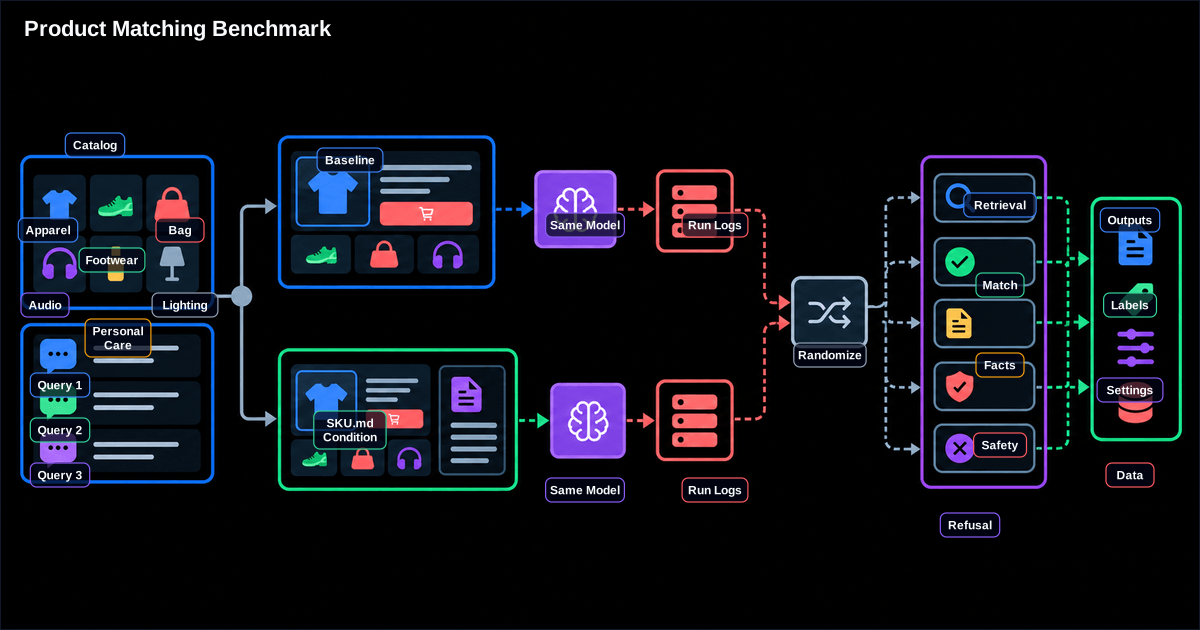
Benchmark 應該回答一個範圍明確的因果問題:在其他條件一致時,能讀取 SKU.md 的一組,是否在既定的商品匹配任務上表現得更好?它的設計不能是為了做出好看的發布數字。本文先公開實驗協議;在完整實驗可以重現之前,不發表結果結論。
預註冊研究假設
在看到結果前寫明商品樣本、購物問題、預期約束、評分規則、模型、檢索預算、提示詞和排除規則。主比較只包含兩組:普通公開商品資源,以及同樣資源加 SKU.md,其他條件全部保持一致。
同時定義什麼結果代表沒有改善或產生傷害。無法否證自身主張的 Benchmark 只是行銷材料。
建立有代表性的問題集
覆蓋精確查詢、屬性比較、相容性、使用建議、限制敏感請求、身分和變體問題,以及應交給即時系統的問題。既取樣資料完整的商品,也取樣資訊稀疏商品,並保留隱藏評估項,避免作者針對每道題最佳化文件。
標註者要記錄硬約束、可接受替代、決定性來源,以及是否預期拒答。
評分不能只看檢索
同時衡量正確候選是否被取回、決定性事實是否準確、來源是否支援陳述、限制是否得到尊重,以及證據不足時是否正確拒答或追問。單一首選準確率可能掩蓋不安全解釋。
樣本較小時報告置信區間或逐題結果,不能把實驗差值擴大成排名、引用、轉換或所有模型的承諾。
對評審隱藏實驗條件
人工評分前移除分組標籤和展示線索。主觀適用性至少由兩名評審判斷,預先定義分歧解決方式並保留備註。精確識別碼和來源 URL 可以自動評分,複雜推薦仍需明確 rubric。
儲存可重現實驗包
| 材料 | 必須包含 |
|---|---|
| 語料 | 精確頁面與 SKU.md 版本或快照 |
| 問題 | 提示詞、約束、預期動作 |
| 執行環境 | 模型、消費者、依賴和設定 |
| 隨機性 | 種子與取樣設定 |
| 輸出 | 原始答案、檢索資源、引用 |
| 評分 | rubric、評審決定、指令碼 |
| 失敗 | 排除項、超時、格式錯誤案例 |
失敗案例必須和平均值一起發布
展示 SKU.md 沒有產生差異、引入陳舊或衝突知識、造成錯誤匹配的案例。這些材料決定下一步要改規範還是改寫作方式。沒有失敗分析的平均提升很難可信。
結果發布條件
只有第二位人員能夠執行文件化流程,並在宣告容差內重現結果表,才能發布 Benchmark 結果。滿足條件前,文章只描述實驗協議,不寫虛構結果。
執行前固定比較條件
Baseline 與 SKU.md 組必須使用相同商品、問題、模型、預算、工具和即時狀態政策,唯一計劃內差異是能否使用 SKU.md。凍結快照,記錄版本、提示、隨機種子、超時和失敗。若一組有更多抓取預算或人工修正候選,實驗就無法隔離檔案作用。
問題要覆蓋事實、相容、Limitations、Variant、意圖歧義、缺失證據和即時交接,並包含近似商品與沒有正確推薦的案例。除 Recall 外,還要評分事實、來源、硬約束、錯誤推薦、拒答和交接;延遲與資源單列。
盲評並公開失敗
在人工評審前隱藏組別,主觀專案至少兩人評分,按預先規則解決分歧。重現實驗包包含輸入、快照、設定、原始輸出、評分程式碼、裁決和彙總。
平均值旁必須放分類結果和代表性失敗。只有獨立人員能重跑並在宣告容差內得到結果,才能發布 Benchmark 結果。在此之前,本文只是方法,不能預寫正面結論。
防止題目汙染與選擇性報告
不能用最終評估題反覆改寫 SKU.md。問題應分開發與保留集,記錄開發錯誤引發的內容修改,協議凍結後才啟用保留集。看過結果再重跑,必須作為新實驗公開,不能覆蓋不利結果。
所有預註冊指標都要報告,包括中性或負面結果;隨機模型應給出多次執行波動。缺失輸出、工具失敗和預算耗盡按事先規則計入分母。即使結果很好,也只支援這組資料、消費者、模型與版本,不能推成平台採用、排名或轉換保證。
把編輯成本也納入報告
如果 SKU.md 只有在針對測試題反覆改寫數小時後才更好,這項成本必須和品質結果一起公佈。記錄準備時間、新增說法數量、驗證失敗和維護步驟,避免把隱藏調參勞動轉移到新檔案。
結果解讀也要看權衡:來源準確率提高而 Recall 不變可能仍有價值;Recall 提高卻增加不相容推薦可能有害。沒有一個總分能代替分類結果與失敗案例。
發布前做一次洩漏審計
檢查評估答案是否直接出現在提示、檔名、摘要或評分後設資料中,確認評審者不能從格式猜出實驗組,並驗證兩組的失敗處理完全相同。把審計結果和實驗包一起儲存。
很小的資訊洩漏也可能製造看似明顯的優勢,卻沒有改善商品理解。因此洩漏應視為阻止發布的問題,而不是報告腳註。修復後要作為新執行重新執行,不得只刪除異常樣本。
最後還要核對七語版本是否使用同一實驗邊界、指標和結果發布條件。任何語言都不能把計劃中的假設寫成已經出現的正面結果,也不能省略失敗案例、成本或拒答品質。
失敗樣例與成功結果同樣重要
公開結果時不能只展示命中案例。每次實驗還應列出錯誤檢索、事實引用錯誤、不當推薦、應拒答卻回答,以及依賴即時狀態卻未交接的樣例。評審者需要在不知道實驗條件的情況下打分,隨後再解盲比較兩組表現。模型版本、提示、資料快照、隨機順序和執行日誌必須一併儲存,才能讓第三方重現實驗。